個人サイトとメルマガの裏側にナレッジベースを構築する〜Andrej Karpathy 氏の LLM Wiki 実践 ①〜
先日にこの Ghost でブログ・メルマガ発信を開始したことをお伝えしました。
 Yuta Hayashi
また、このブログ・メルマガとともに私の個人の活動を集約したサイトを構築しました。
Web エンジニアとして個人開発したアプリ、デジタルノマドとして移動してきたフライトの記録、精密栄養カウンセリングの予約ページ、などを集約し、今後も自身の活動に合わせて、このサイトも更新していきます。
これは、ブログ・メルマガのお知らせでも書いた以下の2点を意図したものです。
- 「あらゆる人が」私が「どんな人間であるか」分かる場所をつくる
- 「あらゆるAIが」私が「どんな人間であるか」分かる場所をつくる
ただ、場所をつくることはもちろん、私が設計の根幹においているのは、自身の活動や発信が自動で蓄積・更新されていくナレッジベースです。
これは以前にも触れた、OpenAI 創業メンバーである Andrej Karpathy 氏が提案する LLM Wiki の私なりの実践です。
LLM Knowledge Bases
— Andrej Karpathy (@karpathy) April 2, 2026
Something I'm finding very useful recently: using LLMs to build personal knowledge bases for various topics of research interest. In this way, a large fraction of my recent token throughput is going less into manipulating code, and more into manipulating…
 262588213843476
今回は、この個人サイトとブログ・メルマガの裏側に構築したナレッジベースについて解説します。
これからAIを活用していくうえでみなさんの参考になれば幸いです。
LLM Wiki のざっくり要約
Karpathy 氏の提案は、ひとことで言うと、「元資料を一か所に集め、AI にそれをナレッジベースとして整理・維持させ、そのナレッジベースに問いを投げ、返ってきた答えをまたナレッジベースに戻す」という、知識を積み上げていくための仕組みです。
基本的には人間はナレッジベース自体には手を入れず、問いを投げ、特定の分野やテーマを深ぼっていくのみです。
彼の活動の一つが「研究」であることから、彼は研究テーマの理解を速く深くする目的でこれを実践しているようですが、私の場合は、自身の活動として「発信」をこの仕組みに取り入れることにしました。
では、私の活動に当てはめて実践した内容を説明していきます。
全体像
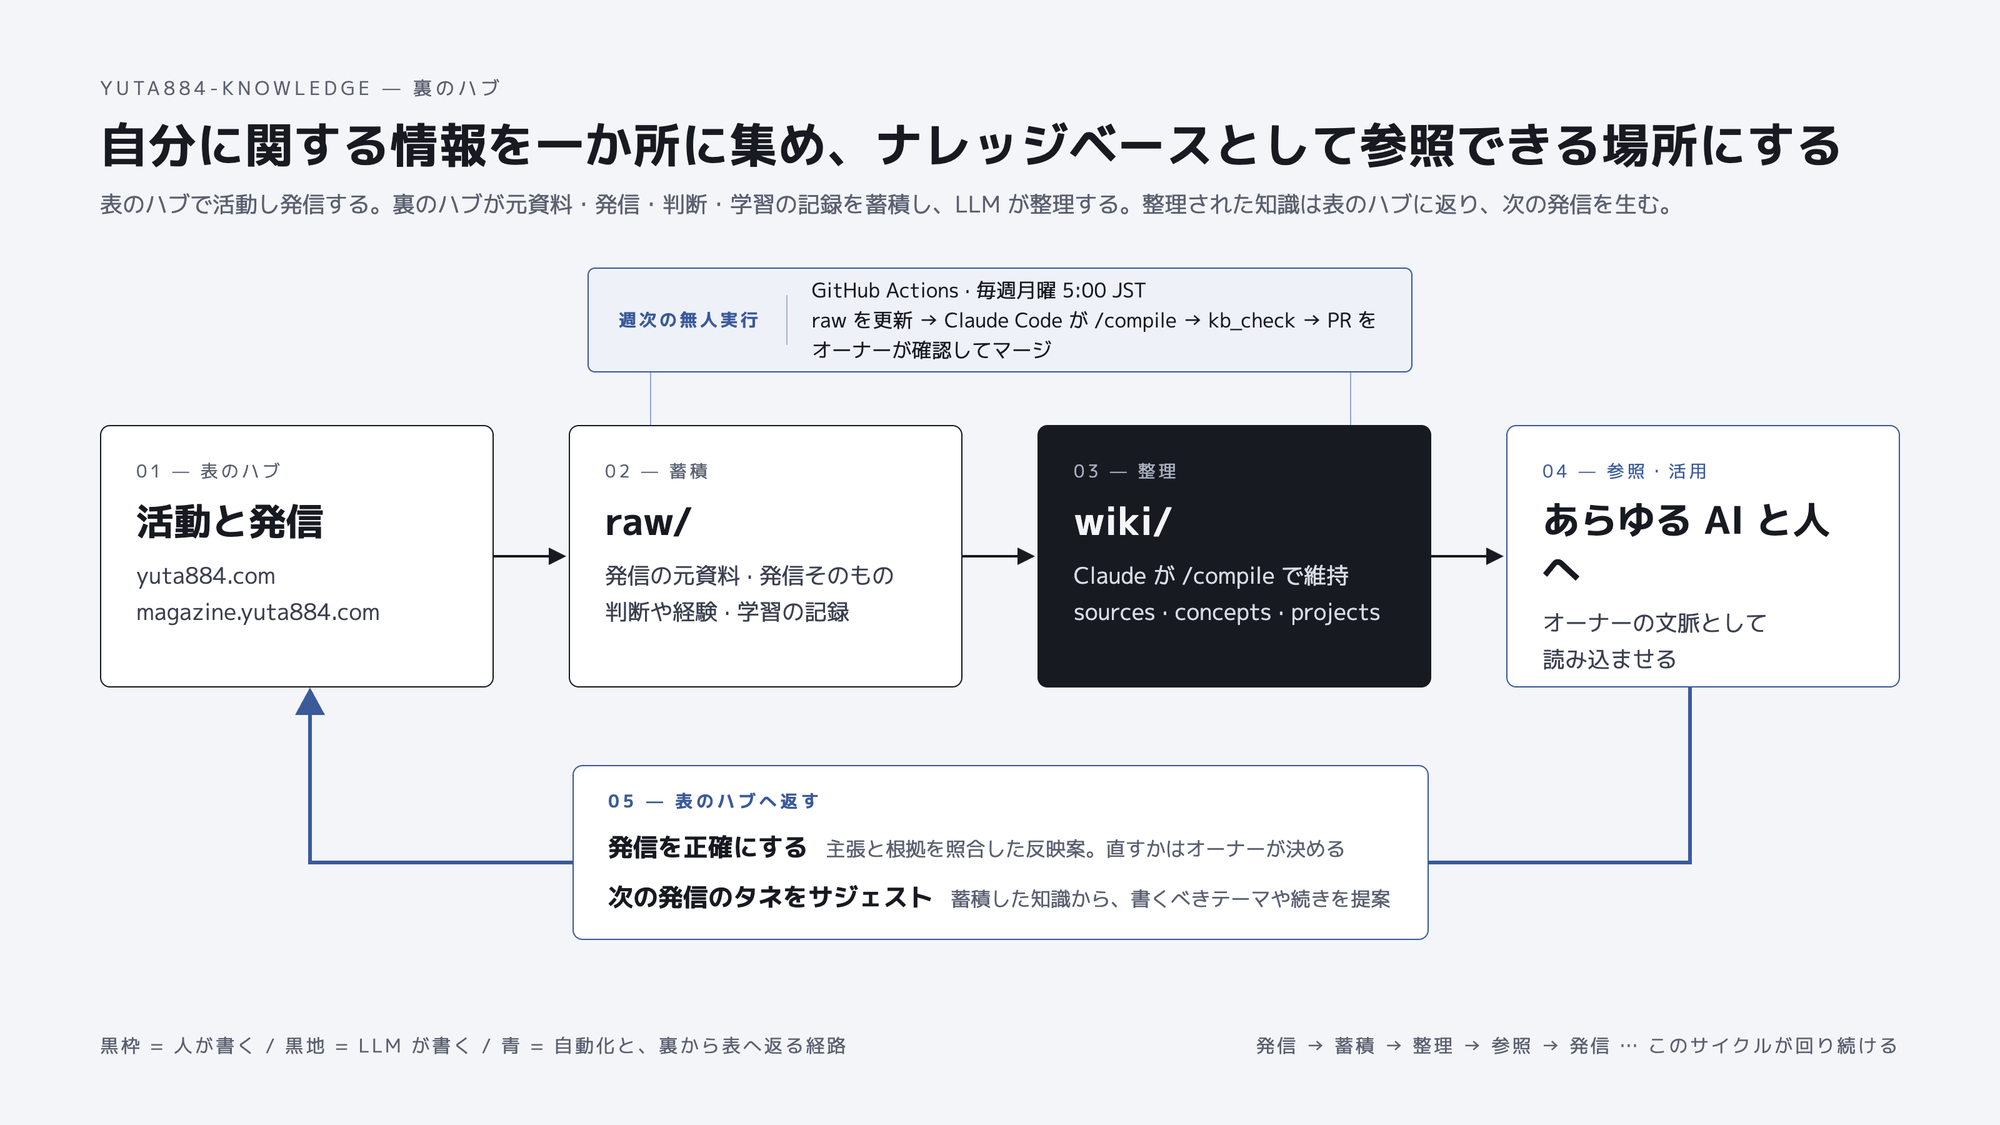
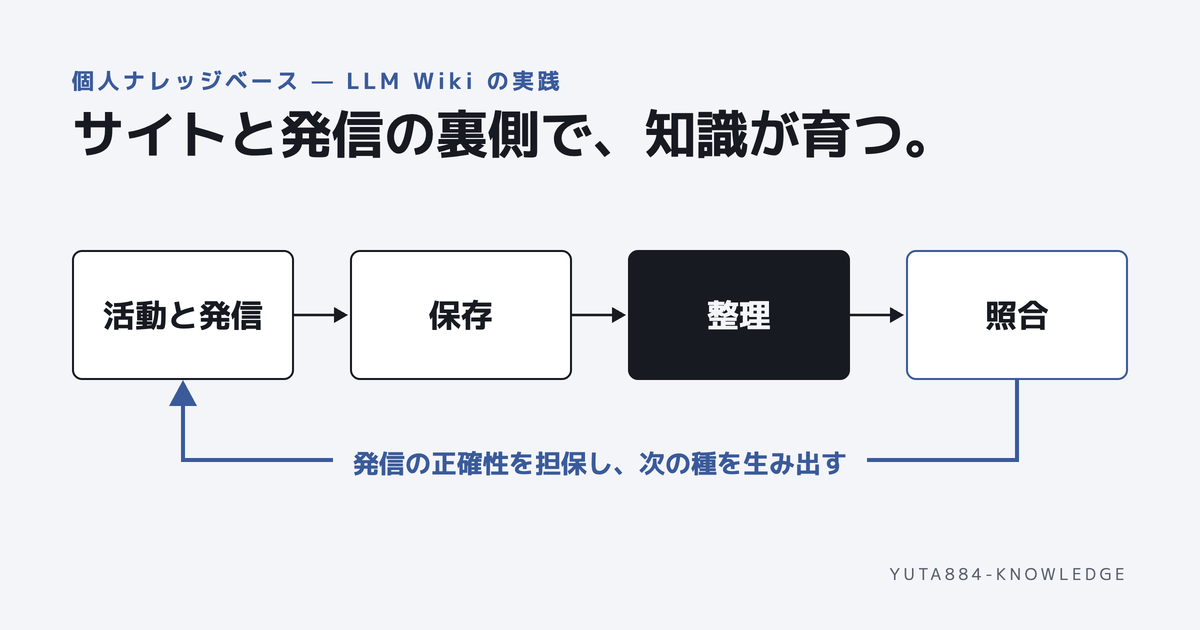
黒枠は人が書く場所、黒地は LLM が書く場所、青は自動化と、裏側から表側へ返ってくる経路です。
「活動・発信 → 蓄積 → 整理 → 照合」と進み、最後に再び「活動・発信」につながるループになっています。順に説明します。
1 活動と発信
ループの起点となるのは、冒頭で紹介した私の個人サイト yuta884.com と、この Ghost で構築したブログ・メルマガ magazine.yuta884.com です。
サイトには個人開発のアプリ、フライトの記録、精密栄養カウンセリングの案内、進行中のプロジェクトなどを置き、マガジンには移動生活、コーヒー、生成 AI、精密栄養学について書いています。
ここは私が日々の活動を通してアウトプットする場所です。これは実質的に私自身の活動そのものです。
2 元資料を保存
書いたもの、読んだもの、決めたことは、すべて raw/ というフォルダに集約されていきます。
magazine.yuta884.com の記事は毎週自動で取り込まれ、サイトのページに更新があればこれも同様に自動で取り込まれます。加えて、読んだ論文や記事の切り抜き、学習ログ、公開前の下書き、そして「これはこう判断した」という私自身の発言の記録なども取り込まれていきます。
このフォルダには一つルールがあります。
「AI には読むことだけを許可して書き換えさせない」ということです。
つまりここは私の活動や発信とその裏付けとなる情報などの生データであり、これらの生データが勝手に変わらないことを担保することで、同時に後続の処理の信頼性をここで担保しています。
3 知識ベースに整理
raw/ にファイルが追加されると、AI がそれを読んで、wiki/ に記事として書き起こしてもらうことで、ナレッジベースとして整理します。
具体的には、raw/ のデータ 1 件ごとに要約ページを作り、テーマをまたぐ内容は横断記事にまとめ、進行中のプロジェクトなどはその現状とログを更新します。
ここのフォルダにもルールがあり、それは「出典のない主張は書かない」こと。
すべての記述は元資料への参照を持ち、Obsidian で開けば元資料まで辿れます。整理された知識ベースは、あらゆる AI に「私の文脈」として読み込ませることができますし、必要なら人に対しても共有ができます。
ここはAIが書いたデータを置く場所で、私は基本的に触りません。
今回立ち上げにあたって、note から移行した記事も含む記事 51 本を含む元資料 65 本から、136 本の Wiki 記事と 2,000 本を超える相互リンクが生まれました。
こんな作業は私にはとても運用できません。AI があってできることです。
4 主張と根拠を照合
ここからが、Karpathy 氏の使い方に私なりの使い方を足した部分であり、またこの仕組みの中心です。
このようにナレッジベースとして構築することで、記事どうしの記述の食い違いや、根拠の弱い主張などが把握できるようになります。
実際に、ビタミン B6 やビタミン D の摂取量について、私の記事の数値と一次資料の数値にずれがあることが見つかり、いずれも記事の修正につながりました。
つまりこのナレッジベースは「私の理解の誤りに対して、指摘や反論をしてくれる」存在です。
また私が疑問をこのナレッジベースに投げれば、出典付きで答えを返してくれます。
例えば「各ビタミンB についての記事全体で、私が推奨している食品と避けるべきとする食品は、記事をまたいで一貫しているか、共通して推奨している食品はなにか」といった、自分の発信全体を横断していないと答えられない問いにも答えてもらえます。
5 表のハブへ返す
私の発信や主張、その根拠がナレッジベースで照合・整理されると、大きく分けて以下の3パターンで私の活動へとフィードバックされます。
この部分は自動ではなく、私がコマンドを実行したときに動きます。
発信を正確にする
公開済みの記事に /feedback コマンドを実行すると、記事の主張を一つずつ抜き出し、Wiki と一次資料に照らして、根拠の追記案や修正案を返してきます。
ただすべての発信に対して根拠を記載するのは大変、かつ読む側も読みづらいと思うので、直すか見送るかは私が決め、AIに自動で記事を書き換えさせることはしません。
次の発信のタネを生む
/ask コマンドとともにナレッジベースに問いを投げると、ナレッジベース内の出典を含めて、その回答が Markdown や図として返ってきます。
また、月に一度の /lint コマンドの実行では、Wiki 全体を点検し、矛盾や欠けている根拠を洗い出すのに加えて、「このテーマは記事になりそうだ」という候補も提案してくれようにしました。
下書き記事に根拠を補強する
これは先述の「発信を正確にする」とほぼ同じですが、下書き記事に /feedback コマンドを実行すれば、その主張を裏づける文献を探して候補を出してきます。
私が承認したものだけを取り込み、公開前の記事にその根拠を追加できます。公開してから直すより、公開前の段階から根拠となる情報が分かるほうが、読者の方々にとっても私にとっても良いと思うので、新たに追加しました。
自動でナレッジベースを更新する仕組み
毎週月曜朝5時に GitHub Actions を定期実行して、新しい記事の取り込みとナレッジベースの整理を自動で実行してもらいます。
ただし自動で実行するのは機械的に検証できる範囲までとして、実際の記事の修正や、参考文献として採用するかといった判断は私が行います。
これから
このような仕組みで、私の活動・発信を検証し、間違いが指摘されるナレッジベースを、「表のハブ」としての個人サイトとブログ・メルマガに対応して、「裏のハブ」として作りました。
私の発信の正確性が担保されることは、私の理解が正されるだけでなく、結果的に読者の方々にも正しい情報が届けられるので有益だと思っています。
そしてこのナレッジベースが、まさに冒頭に書いた「あらゆる AI が私がどんな人間であるか分かる場所」です。
私の活動と考えが、出典も含めて構造化された形で蓄積されている。これが AI にとって、私を正確に理解するための場所になるのです。
そして、発信の場に Ghost を選んだことも実は偶然ではありません。この裏側のナレッジベースの構想まで含めて実現できると分かったからこそ、Ghost を選びました。これについては、機会があればまたどこかで書こうと思います。
ひとまず、自身の活動・発信を続けながら、みなさんにお届けする情報の正確性の担保と、自身の正しい理解を深めるための仕組みとして、このナレッジベースを稼働させてみたいと思います。